| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | 4 | 5 | ||
| 6 | 7 | 8 | 9 | 10 | 11 | 12 |
| 13 | 14 | 15 | 16 | 17 | 18 | 19 |
| 20 | 21 | 22 | 23 | 24 | 25 | 26 |
| 27 | 28 | 29 | 30 |
Tags
- aice associate
- System Call
- Seoul National University
- do it! 알고리즘 코딩테스트: c++편
- Operating System
- file system
- Humble
- cs231n
- reinforcement learning
- Python
- Linux
- Baekjoon
- 밑바닥부터 시작하는 딥러닝2
- CPP
- C++
- DFS
- On-memory file system
- Gentoo2
- ROS2
- SQLD
- CNN
- paper review
- deep learning
- Data Science
- computer vision
- kt aice
- RNN
- Machine Learning
- BFS
- Multimedia
Archives
- Today
- Total
newhaneul
[Stanford Univ: CS234n] Lecture 3. Model-Free Policy Evaluation: Policy Evaluation Without Knowing How the World Works 본문
3. Robotics/Reinforcement Learning
[Stanford Univ: CS234n] Lecture 3. Model-Free Policy Evaluation: Policy Evaluation Without Knowing How the World Works
뉴하늘 2026. 9. 15. 19:20728x90
본 포스팅은 Stanford University School of Engineering의 CS234n: Reinforcement Learning을 수강하고
공부한 내용을 정리하기 위한 포스팅입니다.
https://web.stanford.edu/class/cs234/
CS234: Reinforcement Learning Winter 2026
Credit/No Credit Enrollment If you're enrolled in the class on credit/no credit status, you will be graded on work as usual per standard Stanford rules. The only distinction with those taking the class for letter grade is that you must obtain a C- (C minus
web.stanford.edu
https://www.youtube.com/watch?v=jjq51TRNVvk&t=2s
1. Today's Plan
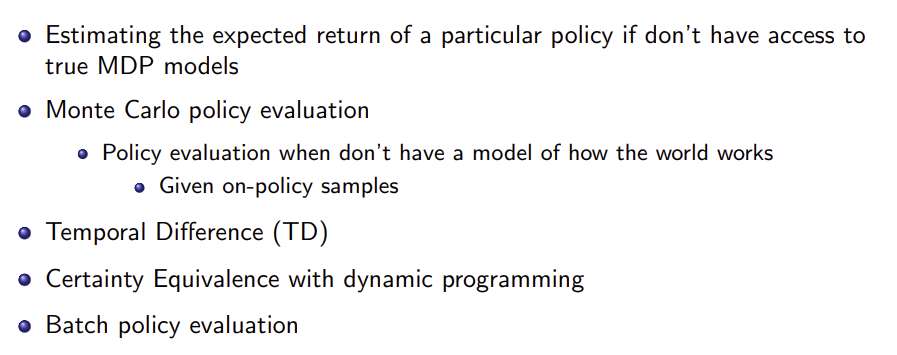
- 이번 강의 핵심은 세계가 어떻게 작동하는지에 대한 모델 (dynamics와 reward model) 없이, 오직 direct experience (직접 경험)만으로 정책 $\pi$의 가치를 추정하는 것이다.
지난 강의에서는 $P$와 $R$을 정확히 알고 있다는 전제 하에 Bellman backup을 이용한 Policy Evaluation을 다뤘지만, 이번 강의부터는 그 전제가 사라진다.- Monte Carlo (MC) Policy Evaluation
- Temporal Difference (TD) Learning
- Certainty Equivalence with Dynamic Programming
- Batch Policy Evaluation
1.1 Recall: Return, $V^\pi, Q^\pi$의 정의
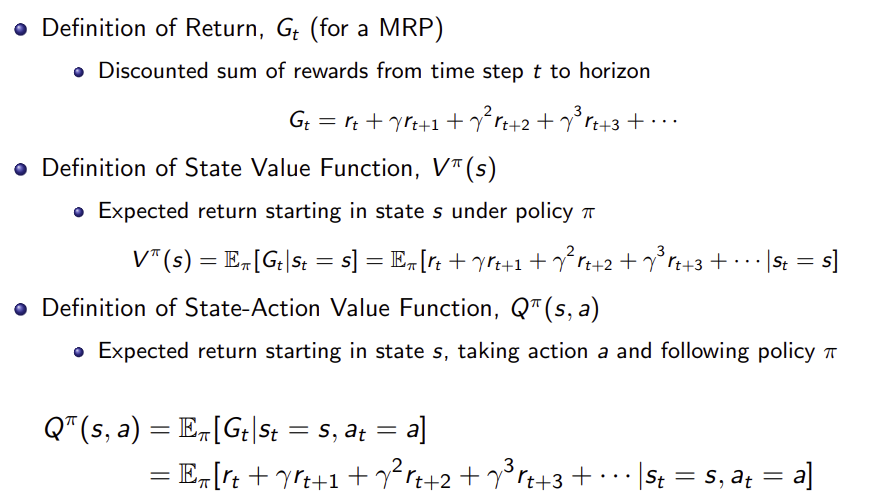
- 지난 강의에서 State Value Function $V^\pi(s)$는 상태 $s$에서 정책 $\pi$를 따랐을 때의 기대 누적 보상이고, $Q^\pi(s, a)$는 상태 $s$에서 행동 $a$를 한 번 취한 뒤 그 다음부터 정책 $\pi$를 따랐을 때의 기대 누적 보상이라고 정의하였다.
- Definition of Return, $G_t$
$$G_t=r_t+\gamma r_{t+1}+\gamma^2r_{t+2}+\gamma^3r_{t+3}+\cdots$$ - Definition of State Value Function, $V^\pi(s)$
$$V^\pi(s)=\mathbb{E}_\pi[G_t\mid s_t=s]$$ - Definition of State-Action Value Function, $Q^\pi(s, a)$
$$Q^\pi(s,a)=\mathbb{E}_\pi[G_t\mid s_t=s,a_t=a]$$
1.2 Recall: Dynamic Programming을 이용한 Policy Evaluation
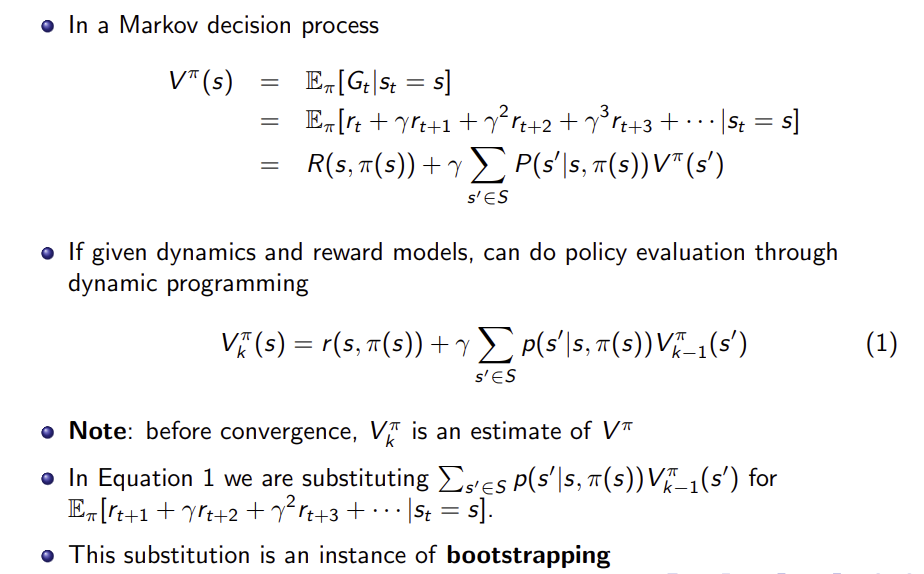
- 모델을 알고 있는 경우, Bellman backup은 다음과 같이 반복적으로 계산된다.
$$V_k^\pi(s)=R(s,\pi(s))+\gamma\sum_{s'\in\mathcal{S}}P(s'\mid s,\pi(s))V_{k-1}^\pi(s')$$
여기서 $\sum_{s'}P(s'\mid s,\pi(s))V_{k-1}^\pi(s')$ 항은 실제 미래의 기댓값 $\mathbb{E}\pi[r_{t+1}+\gamma r_{t+2}+\cdots\mid s_t=s]$을, 이전 반복에서 계산해 둔 추정치 $V_{k-1}^\pi$로 대체한 것이다.- 이렇게 참값 대신 현재 보유한 추정치를 이용해 다음 값을 계산하는 방식을 부트스트래핑 (bootstrapping)이라 부른다.
2. Monte Carlo (MC) Policy Evaluation
2.1 Simple Idea: Value = Mean Return
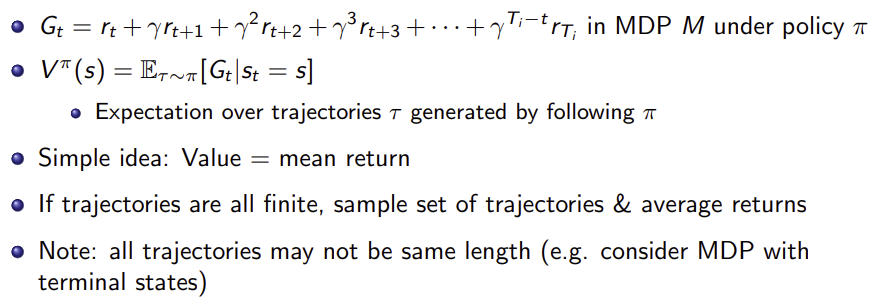
- MC Policy Evaluation의 핵심 아이디어는 정책 $\pi$를 따라 여러 번 에피소드를 진행시켜 본 뒤, 각 에피소드에서 관측된 리턴 $G_t$들의 평균을 $V^\pi(s)$의 추정치로 삼는 것이다.
$$V^\pi(s)=\mathbb{E}_{\tau\sim\pi}[G_t\mid s_t=s]$$
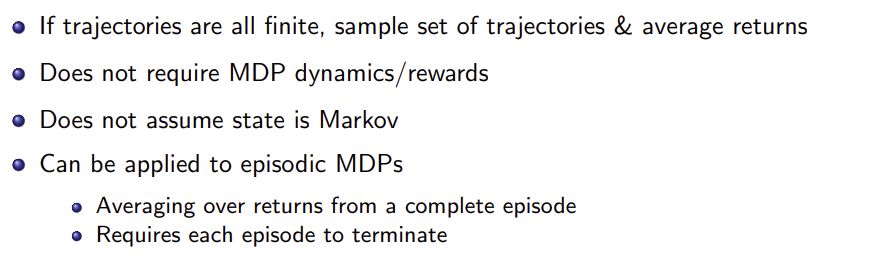
여기서 기댓값은 정책 $\pi$를 따라 생성된 궤적 (trajectory) $\tau$ 전체에 대한 것이다. MC 방법이 가진 성질은 아래와 같다.- MDP의 dynamics/reward 모델을 필요로 하지 않는다.
- state가 Markov라고 가정하지 않는다.
- 에피소드가 끝나야만 그 에피소드의 데이터를 이용해 $V$를 갱신할 수 있으므로, 반드시 episodic한 세팅에서만 적용 가능하다.
2.2 First-Visit MC vs. Every-Visit MC
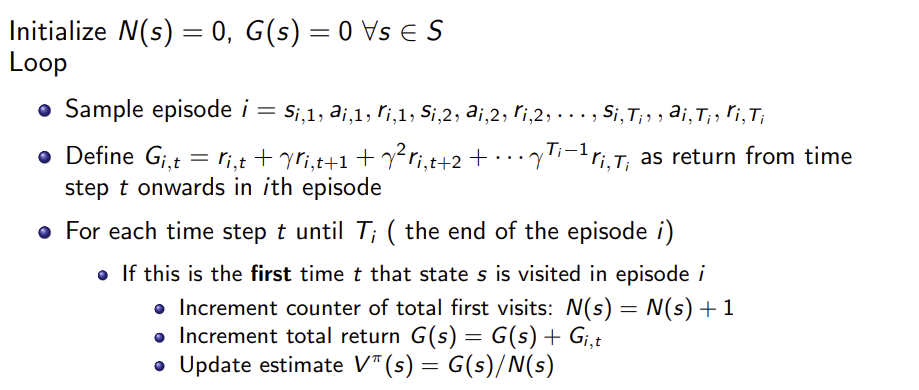
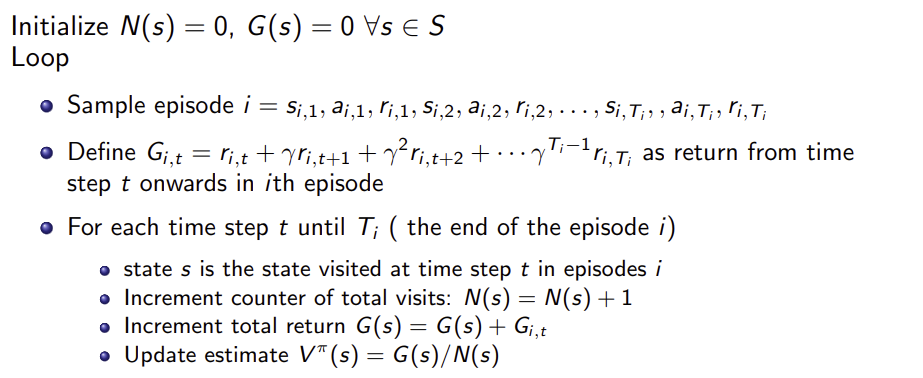
- 두 방식 모두 $N(s)=0, G(s)=0$으로 초기화한 뒤, 에피소드 $i=(s_{i,1},a_{i,1},r_{i,1},\ldots,s_{i,T_i})$ 를 샘플링하고, 시점 $t$부터의 리턴
$$G_{i,t}=r_{i,t}+\gamma r_{i,t+1}+\gamma^2r_{i,t+2}+\cdots+\gamma^{T_i-t-1}r_{i,T_i}$$
을 정의하는 것까지는 동일하다. 두 방식의 차이는 한 에피소드 안에서 같은 상태를 여러 번 방문했을 때 그것을 몇 번 카운트하느냐에 있다.
- First-Visit MC: 한 에피소드 안에서 상태 $s$를 처음 방문한 시점의 $G_{i, t}$만 카운트한다.
- Every-Visit MC: 한 에피소드 안에서 상태 $s$를 방문한 모든 시점의 $G_{i, t}$를 각각 카운트한다.
- 두 경우 모두 갱신 방식은 동일하다.
$$N(s)\leftarrow N(s)+1,\quad G(s)\leftarrow G(s)+G_{i,t},\quad V^\pi(s)=\frac{G(s)}{N(s)}$$
- $N(s)$: 상태 $s$가 지금까지 진행된 전체 에피소드에 걸쳐 몇 번 카운트됐는지를 세는 누적 카운터이다.
- $i$: 에피소드 번호. 정책 $\pi$를 따라 독립적으로 여러 번 시뮬레이션한 것 중 몇 번째 에피소드인지를 의미한다.
- $t$: 그 에피소드 안에서 경과된 step 번호. $t=1$이 에피소드의 시작이고, $T_i$가 종료 시점에 해당된다.
2.3 Worked Example: Mars Rover에서 $V(s_2)$ 계산하기
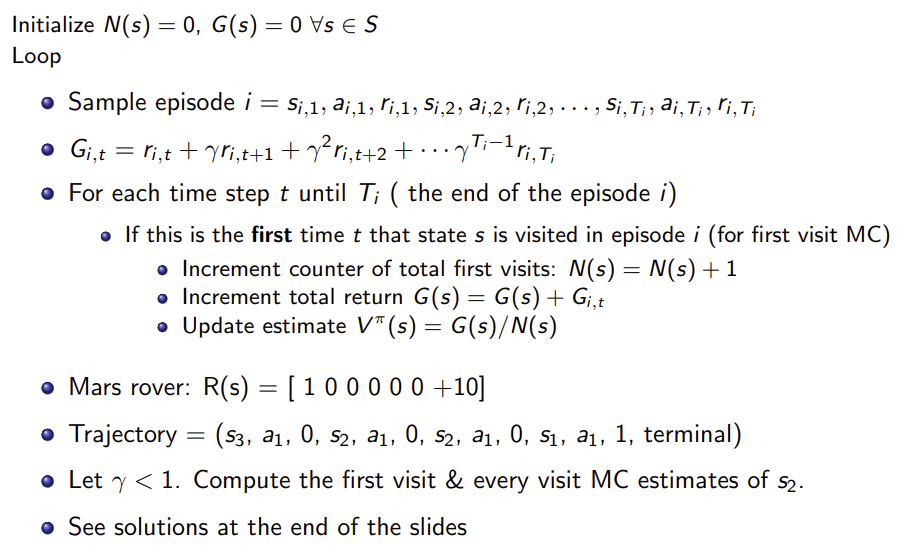
- Mars rover 예시에서 아래 궤적 하나가 주어졌다고 가정한다.
$$\text{Trajectory}=(s_3,a_1,0,s_2,a_1,0,s_2,a_1,0,s_1,a_1,1,\text{terminal})$$
시간 순서대로 정리하면 아래와 같다.
- $t=1$에서 $s=s_3, r_1=0$
- $t=2$에서 $s=s_2, r_2=0$
- $t=3$에서 $s=s_2, r_3=0$
- $t=4$에서 $s=s_1, r_4=1$
- 각 시점부터의 리턴을 순서대로 계산하면 다음과 같다.
$$G_{i,2}=r_2+\gamma r_3+\gamma^2r_4=0+\gamma\cdot0+\gamma^2\cdot1=\gamma^2$$
$$G_{i,3}=r_3+\gamma r_4=0+\gamma\cdot1=\gamma$$- First-Visit MC 추정치: $s_2$의 첫 방문인 $t=2$의 리턴만 사용하므로
$$V^\pi(s_2)=G_{i,2}=\gamma^2$$ - Every-Visit MC 추정치: $t=2$와 $t=3$의 리턴을 모두 사용해 평균을 내므로
$$V^\pi(s_2)=\frac{G_{i,2}+G_{i,3}}{2}=\frac{\gamma^2+\gamma}{2}$$
- First-Visit MC 추정치: $s_2$의 첫 방문인 $t=2$의 리턴만 사용하므로
2.4 Incremental MC Policy Evaluation
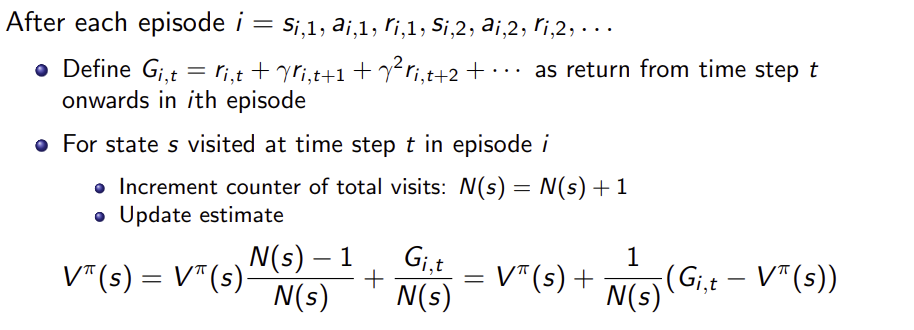

- 매 에피소드가 끝날 때마다 $G(s)$와 $N(s)$를 따로 누적하는 대신, 방문할 때마다 바로 평균값을 갱신하는 증분(incremental) 형태로 다시 쓸 수 있다.
$$V_{N-1}(s)=\frac{1}{N-1}\sum_{k=1}^{N-1}G_k\Longrightarrow\sum_{k=1}^{N-1}G_k=(N-1)V_{N-1}(s)$$
$$V_N(s)=\frac{1}{N}\sum_{k=1}^{N}G_k=\frac{1}{N}\left(\sum_{k=1}^{N-1}G_k+G_N\right)=\frac{(N-1)V_{N-1}(s)+G_N}{N}$$
$$V_N(s)=\frac{NV_{N-1}(s)-V_{N-1}(s)+G_N}{N}=V_{N-1}(s)+\frac{G_N-V_{N-1}(s)}{N}$$
$$V^\pi(s) = V^\pi(s)+\frac{1}{N(s)}\left(G_{i,t}-V^\pi(s)\right)$$
여기서 $1/{N(s)}$ 대신 일반적인 학습률 (learning rate) $\alpha$를 사용하면 다음과 같은 형태가 된다.
$$V^\pi(s_{i,t}) = V^\pi(s_{i,t})+\alpha\left(G_{i,t}-V^\pi(s_{i,t})\right)$$
해당 식은 $\text{현재 추정치} + \text{학습률} \times (\text{목표값} - \text{현재 추정치})$의 구조를 갖는데, 이후 다를 여러 강화학습 알고리즘이 공통으로 갖는 형태에 해당된다.
Batch vs. Incremental 정리
| Batch (단순 합산) 방식 | Incremental 방식 | |
| 상태 $s$ 마다 저장하는 값 | $G(s)$ (누적 합), $N(s)$ (개수) | $V(s)$ (현재 평균 추정치), $N(s)$ (개수) |
| $V(s)$를 구하는 방법 | 필요할 때 $G(s) / N(s)$로 나눗셈 | 이미 $V(s)$가 저장돼 있으므로 바로 읽으면 됨 |
First-Visit vs. Every-Visit 정리
| Batch 방식 | Incremental 방식 $(\alpha = 1/N)$ | Incremental 방식 $(\text{고정} \alpha)$ |
|
| First-Visit | 기본 정의 | 수치적으로 완전히 동일 | 다른 값 (최근 에피소드에 가중치$\uparrow$) |
| Every-Visit | 기본 정의 | 수치적으로 완전히 동일 | 다른 값 (최근 방문에 가중치$\uparrow$) |
2.5 Evaluation of the Quality of a Policy Estimation Approach: Bias, Variance, MSE and Consistent Estimator

- Policy Estimation Algorithm (First-Visit, Every-Visit, Incremental MC, TD 등)을 비교할 때 얼마나 좋은 추정량인가를 비교하려면 수치로 정의할 기준이 필요하다 (Bias, Variance, MSE). 그리고 Algorithm은 다음 다섯 가지 기준을 함께 고려해야 한다.
- Consistency: 데이터가 충분히 많아지면 참값으로 수렴하는가
- Computational complexity: 데이터가 늘어날 때 갱신에 드는 계산 비용
- Memory requirements: 필요한 메모리
- Statistical efficiency: 데이터의 양 대비 정확도가 얼마나 빨리 개선되는가
- Empirical accuracy: 보통 MSE로 측정
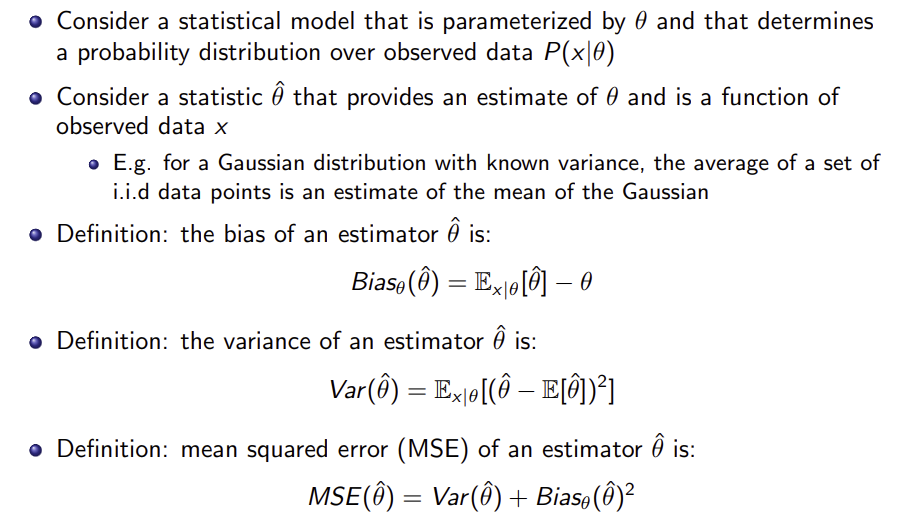
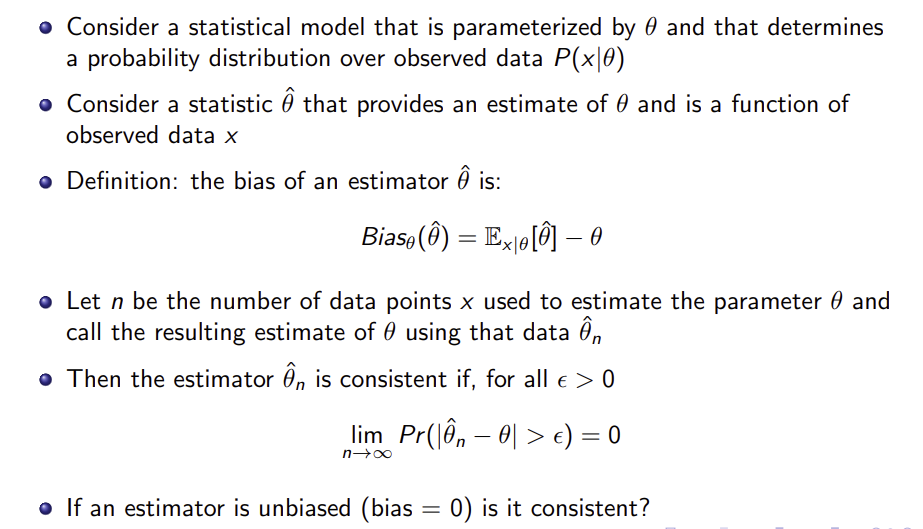
- Definition: the bias of an estimator $\hat{\theta}$ is:
$$\text{Bias}_\theta(\hat\theta) = \mathbb{E}_{x\mid\theta}[\hat\theta] - \theta$$ - Definition: the variance of an estimator $\hat{\theta}$ is:
$$\text{Var}(\hat\theta) = \mathbb{E}_{x\mid\theta}\big[(\hat\theta - \mathbb{E}[\hat\theta])^2\big]$$ - Definition: mean squared error (MSE) of an estimator $\hat{\theta}$ is:
$\mu = \mathbb{E}[\hat{\theta}]$라 두고 유도 진행.$$\text{MSE}(\hat\theta) = \text{Var}(\hat\theta) + \text{Bias}_\theta(\hat\theta)^2$$
$$\hat{\theta} - \theta = (\hat{\theta} - \mu) + (\mu - \theta)$$
양변을 제곱하면,
$$(\hat{\theta} - \theta)^2 = (\hat{\theta} - \mu)^2 + 2(\hat{\theta} - \mu)(\mu - \theta) + (\mu - \theta)^2$$이제 양변에 기댓값을 씌운다. 핵심은 $\mathbb{E}[\hat{\theta} - \mu] = \mu - \mu = 0$이 되는 것이다.
$$\mathbb{E}\big[(\hat{\theta} - \theta)^2\big] = \mathbb{E}\big[(\hat{\theta} - \mu)^2\big] + 2(\mu - \theta)\mathbb{E}[\hat{\theta} - \mu] + (\mu - \theta)^2$$$$\mathbb{E}\big[(\hat{\theta} - \theta)^2\big] = \text{Var}(\hat{\theta}) + 0 + \text{Bias}_\theta(\hat\theta)^2$$ - 즉 MSE는 분산과 편향의 제곱을 더한 값이며, 편향이 0이 아니더라도 분산이 충분히 작다면 오히려 MSE가 더 작을 수 있다는 점이 핵심이다. 데이터 수 $n$에 대해 추정량 $\hat{\theta}_n$이 다음을 만족하면 일관된 (consistent) 추정량이라 부른다.
$$\lim_{n \to \infty} \Pr(\vert{}\hat{\theta}_n - \theta\vert{} > \epsilon) = 0, \quad \forall \epsilon > 0$$
$\to$ 작은 오차 허용치 $\epsilon$을 잡더라도, 데이터를 충분히 많이 모으면 $\hat{\theta}_n$이 참값 $\theta$에서 $\epsilon$ 이상 벗어날 확률이 결국 0으로 수렴한다.- If an estimator is unbiased (bias = 0) is it consistent?
- 평균이 맞아도 (unbiased) 데이터가 더 많아졌을 때 variance가 줄지 않으면 consistent가 아닐 수 있다.
- If an estimator is unbiased (bias = 0) is it consistent?

- First-Visit Monte Carlo:
- $V^\pi$ 추정량은 참값에 대해 unbiased이다.
- 대수의 법칙 (law of large numbers)에 의해 $N(s) \to \infty$일 때 $V_\pi(s) \to \mathbb{E}_\pi \big[ G_t \mid s_t = s \big]$로 수렴한다.
- Every-Visit Monte Carlo:
- $V^\pi$ 추정량은 biased되어 있지만 일관성 (consistent)은 있으며, 실제로는 MSE 기준에서 First-Visit보다 더 나은 경우가 많다.
- Incremental Monte Carlo:
- 학습률 $\alpha$의 선택 방식에 따라 성질이 달라진다.
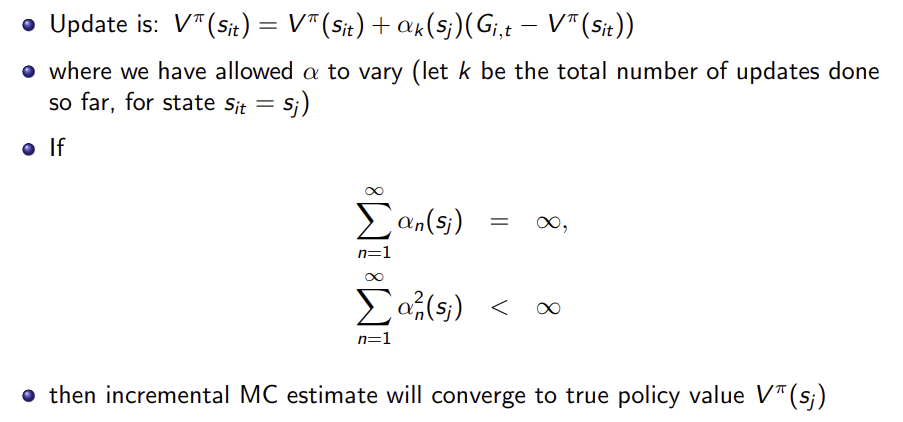
- Incremental MC가 참값으로 수렴하기 위한 조건은 학습률 $\alpha$가 시점 $n$에 대해 다음 두 조건을 만족해야 한다는 것이다.
$$\sum_{n=1}^{\infty} \alpha_n(s_j) = \infty, \quad \sum_{n=1}^{\infty} \alpha_n^2(s_j) < \infty$$- 첫 번째 조건은 학습률의 합이 발산해야 한다는 뜻으로, 초기의 잘못된 추정치를 얼마든지 큰 폭으로 수정할 수 있을 만큼 충분한 크기가 있어야 함을 의미한다.
- 두 번째 조건은 학습률의 제곱합은 수렴해야 한다는 뜻으로, 갱신 폭이 시간이 지남에 따라 충분히 작아져서 최종적으로 값이 한 점에 안정적으로 수렴해야 함을 의미한다.
2.6 Monte Carlo (MC) Policy Evaluation Key Limitations
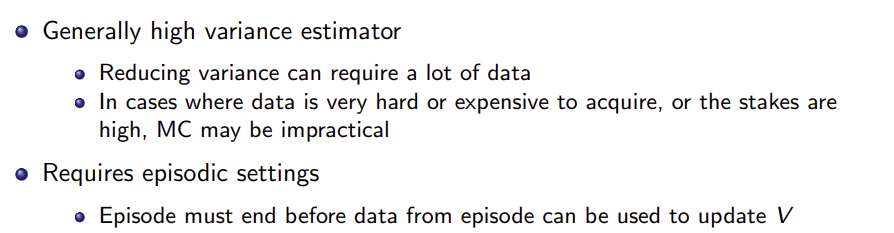
- 일반적으로 분산이 큰 추정량이다. 분산을 줄이려면 많은 데이터가 필요한데, 데이터를 얻기 어려운 상황에서는 MC를 적용하기 어렵다.
- 반드시 episodic한 세팅이 필요하다. 에피소드가 끝나야만 그 데이터를 $V$ 갱신에 사용할 수 있기 때문이다.
2.7 Monte Carlo (MC) Policy Evaluation Summary
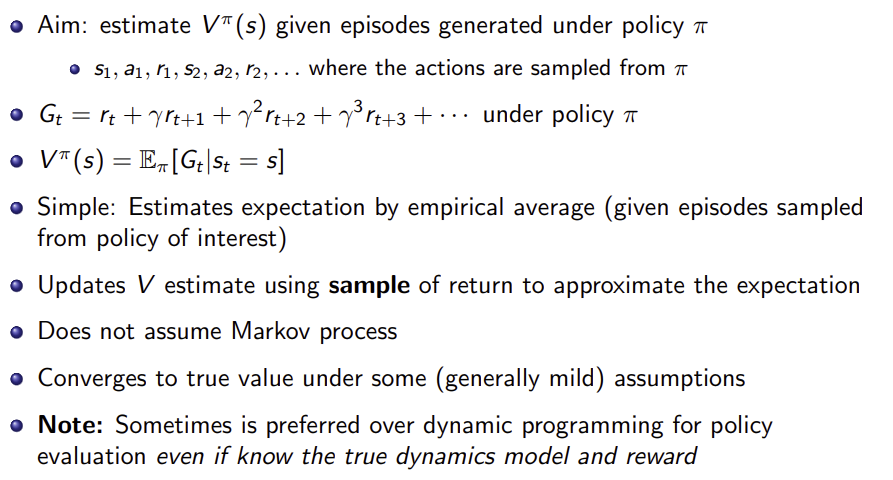
- MC Policy Evaluation은 정책 $\pi$ 하에서 생성된 에피소드들로부터 $V^\pi(s) = \mathbb{E}_\pi[G_t \mid s_t = s]$를 경험적 평균으로 추정하는 방법이다.
Markov 가정을 사용하지 않으며, 일정한 조건 하에서 참값으로 수렴한다.
실제로 dynamics와 reward 모델을 알고 있더라도, 문제에 따라 DP 대신 MC를 선호하는 경우도 있다.
3. Temporal Difference (TD) Learning
3.1 Temporal Difference (TD) Learning
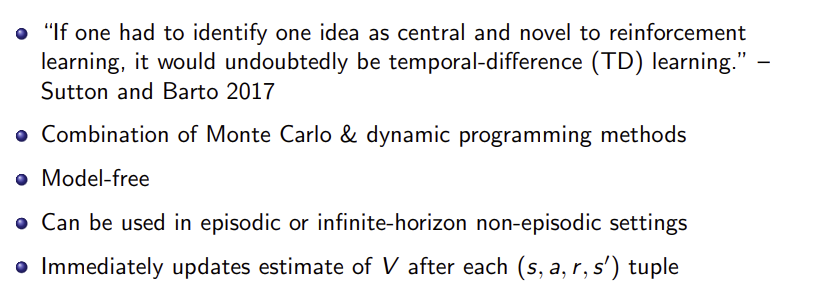
- Temporal Difference Learning은 Monte Carlo와 Dynamic Programming의 아이디어를 결합한 방법으로, model free이면서도 episodic 뿐 아니라 infinite-horizon non-episodic한 세팅에도 적용할 수 있고, 하나의 $(s, a, r, s')$ 튜플이 관측될 때마다 즉시 $V$ 추정치를 갱신한다.
3.2 Incremental MC에서 TD로의 전환
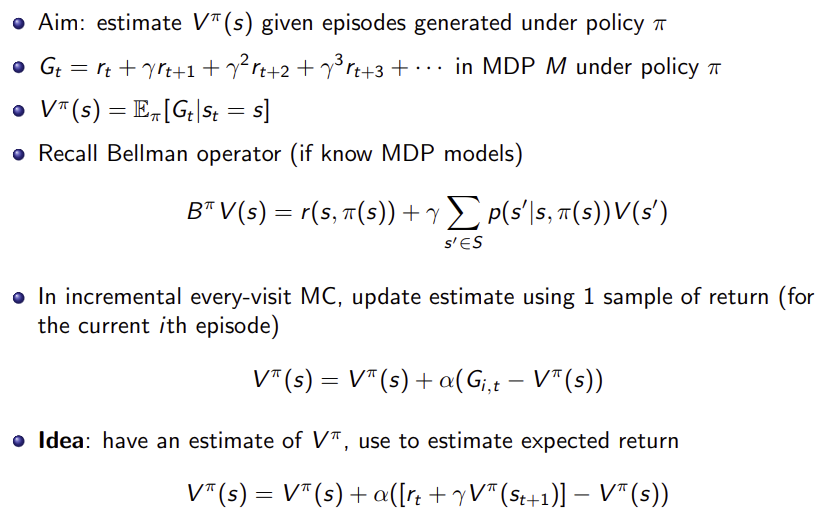
- 앞서 본 incremental every-visit MC의 갱신식을 다시 살펴보면,
$$V^\pi(s)=V^\pi(s)+\alpha\left(G_{i,t}-V^\pi(s)\right)$$
이 식은 실제 리턴 $G_{i,t}$ 하나의 표본을 이용해 기댓값 $\mathbb{E}_\pi[G_t\mid s_t=s]$를 근사하는 것이다. 그런데 $G_{i,t}$는 에피소드가 끝날 때까지 기다려야 알 수 있는 값이다.
TD의 핵심 아이디어는, $G_{i,t}$ 전체를 기다리는 대신, 이미 갖고 있는 $V^\pi$ 추정치를 이용해 $G_{i,t}$를 근사하는 것이다.
$$V^\pi(s)=V^\pi(s)+\alpha\left([r_t+\gamma V^\pi(s_{t+1})]-V^\pi(s)\right)$$
즉 실제 리턴 $r_t+\gamma r_{t+1}+\gamma^2r_{t+2}+\cdots$ 대신, 바로 다음 한 스텝의 보상 $r_t$만 실제로 관측하고, 그 이후의 몫은 현재 추정치 $V^\pi(s_{t+1})$로 대체한다.
3.3 Temporal Difference $[TD(0)]$ Learning
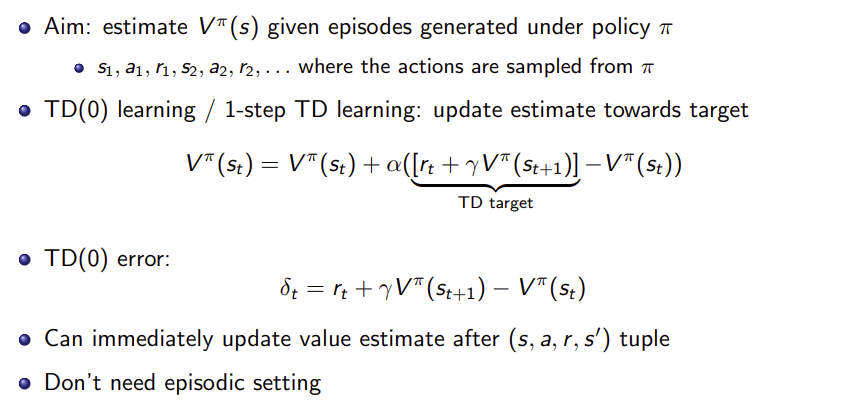
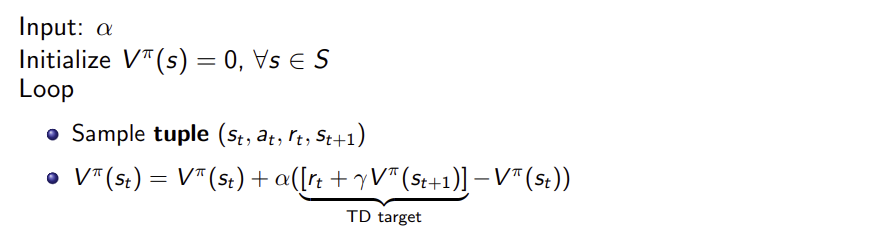
- $TD(0)$, 즉 1-step TD Learning은 아래와 같이 정의된다.
$$V^\pi(s_t)=V^\pi(s_t)+\alpha\left([r_t+\gamma V^\pi(s_{t+1})]-V^\pi(s_t)\right)$$
이때 괄호 안의 값을 TD target, 그리고 TD target에서 현재 추정치를 뺀 값을 TD error라 부른다.
$$\delta_t=r_t+\gamma V^\pi(s_{t+1})-V^\pi(s_t)$$
Algorithm
Input: α
Initialize V(s) = 0, ∀s ∈ S
Loop:
    튜플 (s_t, a_t, r_t, s_{t+1})을 샘플링
V(s_t) ← V(s_t) + α([r_t + γV(s_{t+1})] − V(s_t))- Monte Carlo와 결정적으로 다른 점은, 에피소드가 끝나기를 기다릴 필요 없이 $(s, a, r, s')$ 튜플 하나만 관측되면 바로 갱신이 가능하다는 것이다. 이 덕분에 TD는 episodic 세팅에 국한되지 않는다.
3.4 Worked Example: TD vs. First-Visit MC
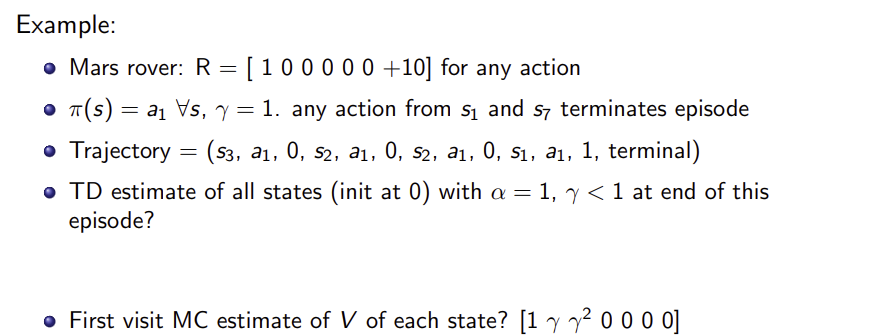
- 이번에는 $\alpha = 1, \gamma < 1$, 모든 상태를 $V(s) = 0$으로 초기화한 상태에서 $TD(0)$를 적용해본다.
$$\mathrm{Trajectory}=(s_3,a_1,0,s_2,a_1,0,s_2,a_1,0,s_1,a_1,1,\mathrm{terminal})$$
튜플을 시간 순서대로 하나씩 처리하면서, 매 튜플마다 그 시점까지 갱신된 $V$ 값을 그대로 다음 계산에 사용한다는 점에 유의해야 한다.
- 튜플 1: $(s_3,a_1,0,s_2):\quad V(s_3)\leftarrow V(s_3)+1\cdot\left[0+\gamma V(s_2)-V(s_3)\right]=0+\left[0+\gamma\cdot0-0\right]=0$
- 튜플 2: $(s_2,a_1,0,s_2):\quad V(s_2)\leftarrow V(s_2)+1\cdot\left[0+\gamma V(s_2)-V(s_2)\right]=0+\left[0+\gamma\cdot0-0\right]=0$
- 튜플 3: $(s_2,a_1,0,s_1):\quad V(s_2)\leftarrow V(s_2)+1\cdot\left[0+\gamma V(s_1)-V(s_2)\right]=0+\left[0+\gamma\cdot0-0\right]=0$
- 튜플 4: $(s_1,a_1,1,\text{terminal}):\quad V(s_1)\leftarrow V(s_1)+1\cdot\left[1+\gamma 0-V(s_1)\right]=0+\left[1+\gamma\cdot0-0\right]=1$
- 따라서 이 에피소드를 한 번 처리한 직후의 $TD(0)$의 추정치는 $V(s_1)=1, V(s_2)=0, V(s_3)=0$이다. TD가 참값에 도달하려면, 같은 데이터를 여러 번 반복해서 학습시키거나 더 많은 에피소드를 거치면서 가치 정보가 뒤에서 앞으로 $(s_1\to s_2\to s_3)$ 점진적으로 전파되어야 한다.
3.5 $\alpha$의 극단값
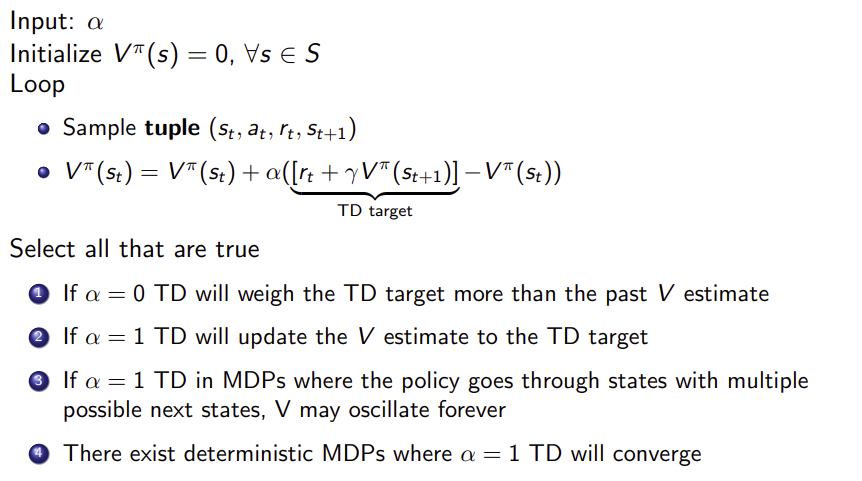
- $\alpha = 0$이면 TD target이 전혀 반영되지 않으므로, $V$ 추정치는 갱신되지 않고 그대로 유지된다.
- $\alpha = 1$이면 $V$ 추정치가 TD target으로 완전히 대체(overwrite)된다.
- $\alpha = 1$이고 어떤 상태에서 다음 상태가 여러 개로 확률적으로 갈리는 MDP라면, 매번 샘플링되는 다음 상태가 달라지므로 $V$ 값이 하나로 수렴하지 못하고 영원히 진동할 수 있다.
- 반대로 결정론적(deterministic) MRP라면, 같은 state-action 쌍은 항상 같은 다음 상태로 이어지므로, $\alpha = 1$인 TD도 수렴할 수 있다.
3.6 Summary: Temporal Difference Learning

- TD Learning은 Monte Carlo와 Dynamic Programming를 결합한 방법이다.
- Bootstraps 와 Sampling을 동시에 사용한다.
- Model-free이고, episodic & non-episodic 세팅 모두에 적용 가능하며, $(s, a, r, s')$ 튜플이 생길 때마다 즉시 갱신된다.
- 초기화 값의 영향을 받기 때문에 biased 추정량이지만, 일반적으로 MC보다 분산이 작다.
4. Certainty Equivalence with dynamic programming
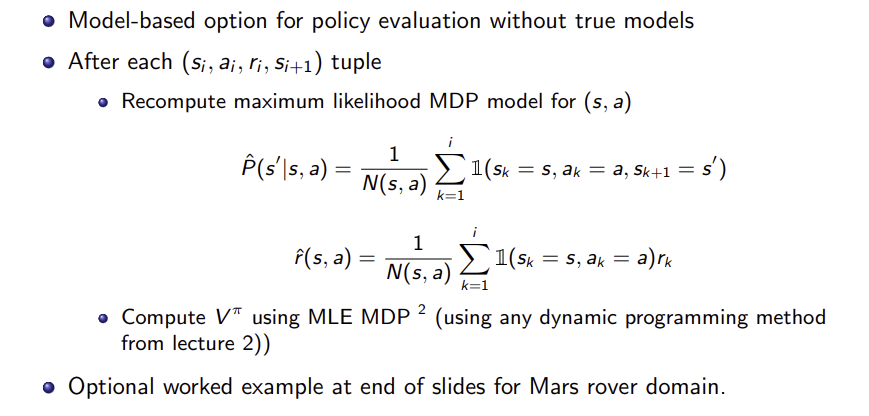
- Certainty Equivalence는 모델을 모르는 상황에서도, 데이터로부터 모델 자체를 추정한 다음 그 추정된 모델 위에서 기존의 Dynamic Programming을 그대로 적용하는 model-based 접근이다.
관측된 $(s_i, a_i, r_i, s_{i+1})$ 튜플들로부터, 각 $(s, a)$ 쌍에 대해 Maximum Likelihood MDP 모델을 다음과 같이 재계산한다.
예를 들어 $(s, a)$를 $N(s, a)$번 관측했는데, 그중 $s'$로 간 횟수가 $n(s, a, s')$번이라 하면:
$$n(s,a,s')=\sum_{k=1}^{i}\mathbf{1}(s_k=s,a_k=a,s_{k+1}=s')$$
$$\hat{P}(s'\mid s,a)=\frac{n(s,a,s')}{N(s,a)}=\frac{1}{N(s,a)}\sum_{k=1}^{i}\mathbf{1}(s_k=s,a_k=a,s_{k+1}=s')$$
$$\hat{r}(s,a)=\frac{1}{N(s,a)}\sum_{k=1}^{i}\mathbf{1}(s_k=s,a_k=a)r_k$$
- $N(s, a)$: 지금까지 관측된 데이터 중 상태 $s$에서 행동 $a$를 취한 횟수
- $\mathbf{1}( ⋅ )$: 괄호 안의 조건이 참이면 $1$, 거짓이면 $0$을 내는 indicator function
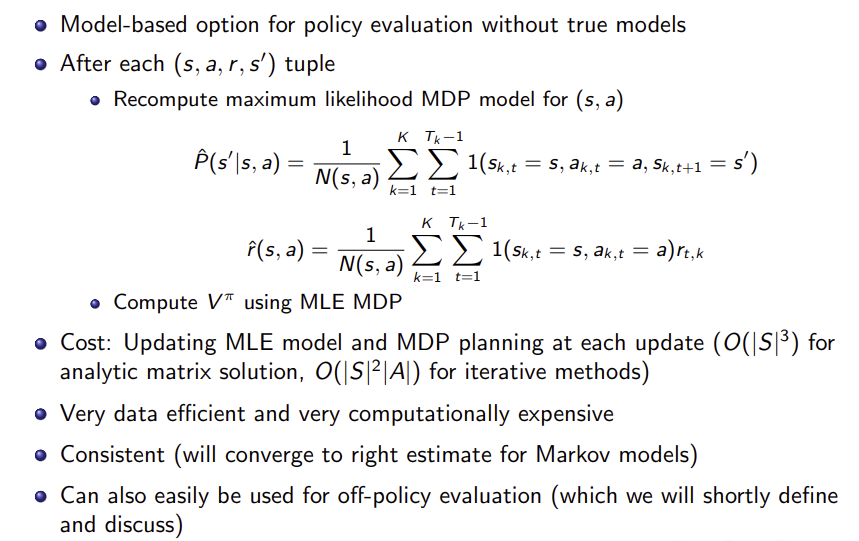
- 즉 상태 $s$에서 행동 $a$를 취했을 때 어떤 다음 상태로 얼마나 자주 이동했는지, 그리고 그때 평균적으로 어떤 보상을 받았는지를 경험적 빈도로 그대로 추정하는 것이다. 이렇게 얻은 $\hat{P},\hat{r}$을 이용해, DP를 바탕으로 $V^\pi$를 계산한다.
- 비용: 매 갱신마다 MLE 모델을 다시 계산하고 MDP를 새로 풀어야 한다.
- Analytic (행렬 해석적 방법): $O(|\mathcal{S}|^3)$
- Iterative (반복적 방법): $O(|\mathcal{S}|^2|\mathcal{A}|)$의 비용이 든다.
- 데이터 효율성은 매우 높지만, 계산 비용이 매우 크다.
- Markov 모델에 대해 consistent 추정량이다.
- 비용: 매 갱신마다 MLE 모델을 다시 계산하고 MDP를 새로 풀어야 한다.
5. Batch MC and TD: Convergence for finite dataset
5.1 Batch (Offline) Setting
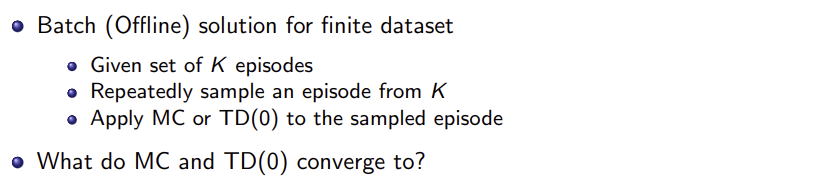
- 지금까지는 데이터가 계속 새로 들어오는 상황을 가정했지만, Batch 세팅에서는 이미 주어진 $K$개의 에피소드라는 고정된 데이터셋 안에서 MC와 $TD(0)$를 반복 적용했을 때 각각 무엇으로 수렴하는지를 묻는다.
방법은 $K$개 에피소드 중 하나를 반복해서 무작위로 뽑아, 그 에피소드에 MC 또는 $TD(0)$를 적용하는 것이다.
5.2 AB Example (Sutton & Barto, 2018, Ex. 6.4)
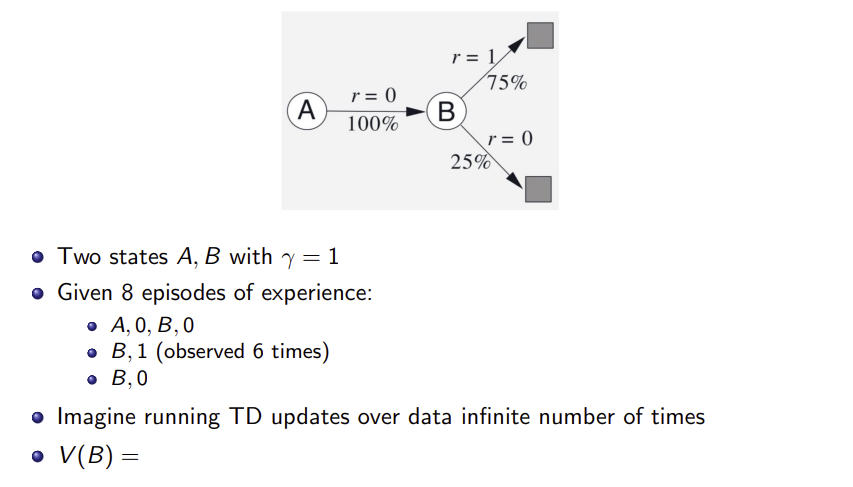
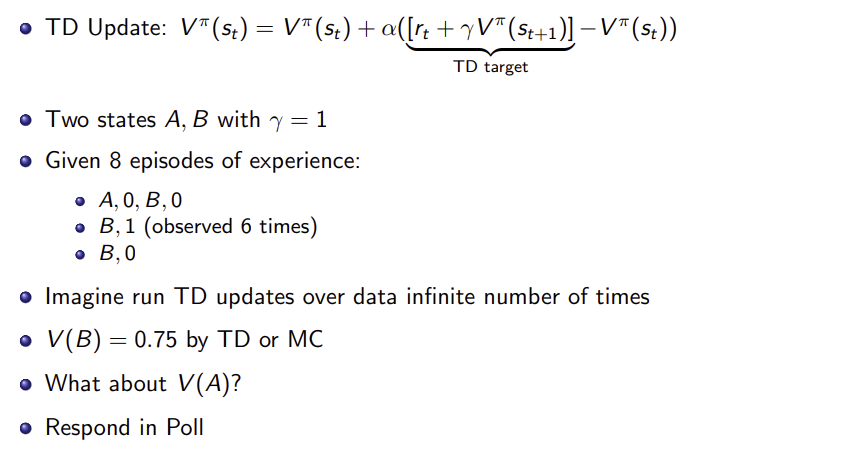
- 상태 $A, B$ 두 개와 $\gamma = 1$이 주어지고, 아래와 같은 8개의 에피소드 경험이 주어졌다고 하자.
- $A, 0, B, 0$ (1회 관측)
- $B, 1$ (6회 관측)
- $B, 0$ (1회 관측)
- $V(B)$부터 계산하면, $B$가 등장한 뒤의 보상만 모아 평균을 내면 되고, 이 값은 MC와 TD 모두 동일하게 수렴한다. $B$는 총 $1+6+1=8$번 등장했고, 그 뒤에 받은 보상의 합은 $0+6\times1+0=6$이므로,
$$V(B)=\frac{6}{8}=0.75$$ - $V(A)$를 계산하면, $A$가 등장한 에피소드는 단 하나 $(A, 0, B, 0)$ 뿐이고, 그 에피소드의 실제 리턴은 0이다.
- Batch MC는 관측된 에피소드의 실제 리턴만을 사용해 평균을 내므로, $A$가 등장한 유일한 에피소드의 리턴 $0$을 그대로 사용한다. 즉 $V(A) = 0$으로 수렴한다. MC는 $A$ 다음에 $B$가 오고, $B$가 평균적으로 0.75의 가치를 가진다는 구조적 정보를 전혀 활용하지 않는다.
$$V(A) = 0$$ - Batch $TD(0)$는 Certainty Equivalence와 동일한 방식으로 동작한다. 즉 데이터로부터 암묵적으로 추정된 MDP 모델을 이용해 Bellman equation을 적용한다.
$$V(A)=R(A\to B)+\gamma V(B)=0+1\times0.75=0.75$$
- Batch MC는 관측된 에피소드의 실제 리턴만을 사용해 평균을 내므로, $A$가 등장한 유일한 에피소드의 리턴 $0$을 그대로 사용한다. 즉 $V(A) = 0$으로 수렴한다. MC는 $A$ 다음에 $B$가 오고, $B$가 평균적으로 0.75의 가치를 가진다는 구조적 정보를 전혀 활용하지 않는다.
- 정리하면 같은 데이터를 가지고도 Batch MC, Batch TD는 서로 다른 값에 수렴한다. 이는 각각 무엇을 정답으로 보는지에 대한 근본적으로 다른 관점에서 비롯된다.
5.3 Generalization: Batch MC & Batch TD
- Batch MC는 관측된 리턴의 평균제곱오차 (MSE)를 최소화하는 값으로 수렴한다. 즉 Markov 구조를 전혀 가정하지 않고, 오직 실제로 관측된 리턴만을 놓고 가장 잘 들어맞는 값을 찾는다.
- Batch $TD(0)$는 데이터로부터 추정한 MLE MDP 모델 하에서의 값, 즉 Certainty Equivalence의 결과와 동일한 값으로 수렴한다. 이는 데이터에 Markov 구조가 실제로 있다는 가정을 적극적으로 활용하는 것이다.
- 따라서 실제 프로세스가 Markov 성질을 만족한다면 TD의 이러한 가정이 적은 데이터로도 더 정확한 일반화를 가능하게 하지만, Markov 가정이 맞지 않는 상황이라면 이 가정 자체가 오히려 편향딘 답으로 이어질 수도 있다.
6 Summary: Policy Evaluation
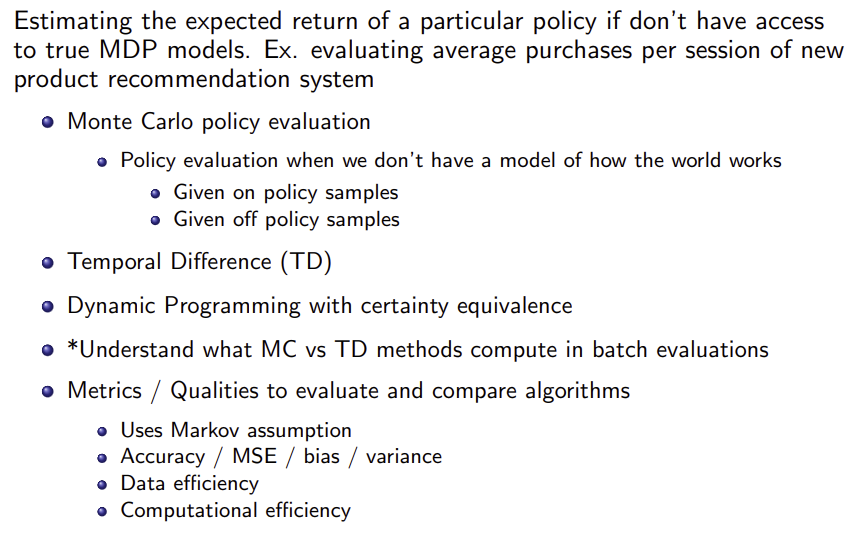
- 이번 강의는 참된 모델 없이 정책의 기대 리턴을 추정하는 문제를 다루었다. 지금까지 다룬 네 가지 방법을 하나의 표로 비교하면 다음과 같다.
| 기준 | MC | TD(0) | Certainty Equivalence |
| 모델 필요 여부 | 불필요 (model-free) | 불필요 (model-free) | 불필요, 데이터로부터 모델 추정 |
| Markov 가정 | 사용하지 않음 | 사용함 (bootstrapping) | 사용함 |
| 편향 (Bias) | First-Visit: unbiased Every-Visit: biased (✅ Consistent) |
biased (✅ Consistent) | ✅ Consistent |
| 분산 (Variance) | 상대적으로 큼 | 상대적으로 작음 | 데이터로부터 결정됨 |
| 에피소드 종료 필요 여부 | 필요 | 불필요 | 불필요 |
| 매 갱신 비용 | $O(1)$ | $O(1)$ | $O(|\mathcal{S}|^3)$ 또는 $O(|\mathcal{S}|^2|\mathcal{A}|)$ |
| 데이터 효율성 | 낮음 | 중간 | 매우 높음 |
728x90
'3. Robotics > Reinforcement Learning' 카테고리의 다른 글
| [Stanford Univ: CS234n] Lecture 2. Making Sequences of Good Decisions Given a Model of the World (0) | 2026.09.08 |
|---|---|
| [Stanford Univ: CS234n] Lecture 1. Introduction to Reinforcement Learning (0) | 2026.09.02 |
| [KAIST: RL] Lecture 3. Markov chain (0) | 2026.08.06 |
| [KAIST: RL] Lecture 2. Dynamic Programming (0) | 2026.08.05 |
| [KAIST: RL] Lecture 1. Fixed-Point Iteration (0) | 2026.08.05 |
'3. Robotics/Reinforcement Learning' Related Articles
more


